Hero Image
CI/CD и инфраструктура для веб-приложения

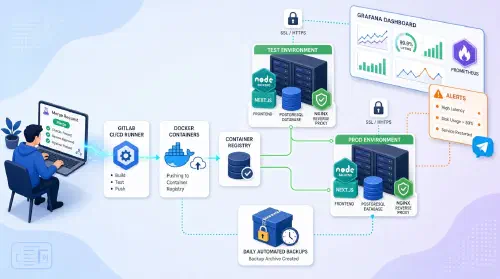
Инфраструктура и CI/CD для сайта компании Клиент Компания-производитель фирменных исследовательских продуктов, которой требовался сайт для публикации каталога продукции Задача Разработчики написали код обычного веб-приложения (backend NestJS + frontend Next.js), но инфраструктура полностью отсутствовала: деплой выполнялся вручную, не было CI/CD, настроенного сервера, мониторинга, бэкапов и разделения тестового и боевого окружений. Требовалось выстроить полный DevOps-стек с нуля: GitLab CI/CD, собственный сервер, два изолированных контура, HTTPS, мониторинг, оповещения и автоматические бэкапы. Решение 1. Подготовка сервера и безопасность VPS на Ubuntu 24.04: 4 vCPU, 6 ГБ RAM, 120 ГБ диск SSH только по ключам, отключён root, выделенный деплой-пользователь (sudo + docker) UFW Firewall: открыты только порты 80, 443, 22 и SFTP (2222/2223) Автоматические обновления безопасности (unattended-upgrades) 2. GitLab CI/CD Self-hosted GitLab с групповым Container Registry Пайплайны для backend и frontend: build → push → deploy Привязка веток: test → образ :test → контур test; master → образ :latest → контур prod; теги v* → релизные сборки; dev → только сборка SSH-деплой на сервер через SSH_PRIVATE_KEY, секреты в Protected CI-переменных Инфраструктурный репозиторий server-devops с джобой deploy-all: жёсткий сброс к origin + docker compose up -d --pull always 3. Docker Compose и контуры Три compose-файла: app/ (test), app-prod/ (prod), monitoring/ на общей Docker-сети Сервисы каждого контура: backend NestJS, frontend Next.js, PostgreSQL 16, pgAdmin, SFTP Политика рестарта on-failure:10 для всех контейнеров приложений Все конфиги, дашборды и правила — в git, применяются пайплайном 4. Reverse Proxy и HTTPS Единый reverse proxy nginx-proxy + acme-companion на портах 80/443 Автоматические сертификаты Let’s Encrypt с автопродлением Все точки входа только по HTTPS: основной сайт, тестовый контур, панель управления БД, мониторинг 5. Мониторинг и алерты Prometheus + Grafana с автоматическим провижинингом дашбордов из git (4 дашборда: cAdvisor, Node Exporter, Logs/App, PostgreSQL) Exporters: node, cAdvisor, postgres, nginx (stub_status + access-лог: RPS, 4xx/5xx, время ответа/апстримов), HTTP-пробы blackbox для frontend/backend Alertmanager с интеграцией в Telegram — один бот, отдельные чаты на каждый контур (test / prod) Правила алертов: падение сервисов, высокая нагрузка CPU/RAM/диск (>80%), циклы рестартов, ошибки 5xx backend 6. Логирование и бэкапы Loki + Promtail: логи всех контейнеров собираются и доступны в Grafana (Logs Drilldown) Автоматический скрипт бэкапа: pg_dump БД prod + tar-стрим тома загрузок prod в единый архив Ротация 30 дней, ежедневный cron в 03:00, процедура восстановления проверена и задокументирована Технологии GitLab CI Docker Prometheus Grafana Nginx PostgreSQL Результаты ✅ Деплой: merge в master → автоматическая сборка, публикация и деплой на сервер ✅ Окружения: полное разделение test и prod на одном VPS через общую Docker-сеть ✅ HTTPS: все сервисы только по HTTPS с автоматическими сертификатами Let’s Encrypt ✅ Мониторинг: 4 дашборда, пробы доступности, алерты в Telegram (отдельные чаты на контур) ✅ Бэкапы: ежедневный бэкап БД prod + тома загрузок, ротация 30 дней, восстановление проверено ✅ Безопасность: SSH по ключам, отключён root, UFW, секреты в Protected CI-переменных
Hero Image
Геораспределённый кластер блокчейн-нод в Kubernetes

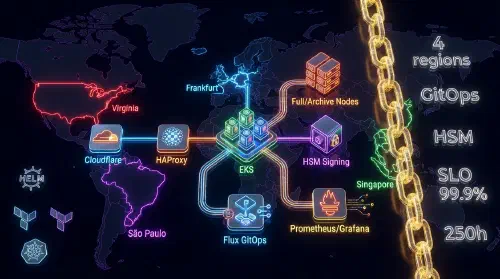
Геораспределённый кластер блокчейн-нод в Kubernetes Клиент Криптовалютная платформа (Web3 / DeFi) Задача Клиенту требовалась отказоустойчивая инфраструктура для запуска ETH и BSC full-нод в четырёх регионах (EU, US, AP, LatAm) с минимальной задержкой для конечных пользователей, защитой от DDoS и спама на RPC, безопасным HSM-подписанием транзакций и централизованным мониторингом. Синхронизация нод с нуля занимает 2–3 недели — требовалось решение для быстрого старта. Решение 1. Инфраструктура и IaC (Terraform + EKS) Terraform-модули: VPC, subnets, security groups для 4 регионов (Frankfurt, Virginia, Singapore, São Paulo) Managed Kubernetes (EKS 1.29+) per region с выделенными node pools: full nodes, archive nodes, signing service NVMe StorageClass (gp3) через CSI-драйвер для высокопроизводительного хранения chaindata Helm chart для geth / bsc-node с кастомными values per region 2. GitOps: Flux CD multi-cluster Flux CD v2 с Kustomization per region — единый источник истины для всех кластеров Secrets management: HashiCorp Vault + External Secrets Operator (ESO) Изменения в инфраструктуре применяются через git push без прямого доступа к кластерам 3. Балансировка и Anti-Spam HAProxy 2.8: sticky sessions, health checks по eth_syncing — трафик только к синхронизированным нодам Nginx Ingress: rate limiting, IP reputation filtering (Lua-скрипты в стиле fail2ban) Cloudflare Workers: geo-routing + защита от DDoS L7 Custom sidecar (Go): health endpoint, который возвращает ready только при полной синхронизации ноды 4. HSM-интеграция для подписания транзакций AWS CloudHSM (prod) / YubiHSM2 (staging) для хранения приватных ключей Go-микросервис с PKCS#11 абстракцией — смена HSM-вендора без переписывания кода Изолированный K8s namespace + NetworkPolicy: нет egress кроме HSM endpoint gRPC API для backend: sign tx, get pubkey Аудит-лог всех операций подписания → Loki 5. Мониторинг и алертинг Custom Prometheus exporter (Go): eth_blockNumber, eth_syncing, peer count per node Grafana dashboards: sync lag, block height per region, RPC latency, SLO 99.9% Alertmanager → PagerDuty: алерты на block lag > N блоков, node down, peer count < threshold Loki + Promtail: структурированные логи всех нод с корреляцией по region/pod 6. Операционка и Disaster Recovery Snapshot bootstrap: chaindata из S3 через rclone — нода готова за часы вместо недель DR playbook: пошаговые runbook’и для восстановления региона Chaos Engineering (Chaos Mesh): тесты на node kill, network partition, pod failure Architecture Decision Records (ADR) для всех ключевых решений Технологии Kubernetes Terraform Helm Flux CD Prometheus Grafana Результаты ✅ Geo-routing: задержка снижена за счёт маршрутизации к ближайшему региону ✅ Быстрый старт: нода готова за часы через snapshot из S3 вместо 2–3 недель синхронизации ✅ Anti-spam: rate limiting + IP reputation — публичный RPC выдерживает нагрузку ботов ✅ HSM: приватные ключи никогда не покидают аппаратный модуль ✅ GitOps: любое изменение инфраструктуры — через git, полный audit trail ✅ SLO 99.9%: отслеживается в Grafana, алерты в PagerDuty при деградации

Hero Image
Мониторинг Prometheus + Grafana

Observability стек для микросервисной архитектуры Клиент Начинающий стартап Задача Компания перешла на микросервисную архитектуру (15+ сервисов), но не имела централизованного мониторинга. Проблемы обнаруживались только по жалобам пользователей через 30+ минут. Требовалось внедрить полноценный observability стек для быстрого выявления и диагностики проблем. Решение 1. Архитектура мониторинга Prometheus для сбора метрик Grafana для визуализации Loki для централизованных логов Jaeger для distributed tracing Alertmanager для уведомлений 2. Сбор метрик Автоматическое обнаружение сервисов в Kubernetes Метрики приложений (custom metrics) Системные метрики (node-exporter) Метрики БД (postgres-exporter, redis-exporter) 3. Визуализация в Grafana Дашборды для каждого микросервиса Общий дашборд инфраструктуры SLA/SLO метрики Business метрики (RPS, конверсия) 4. Централизованные логи (Loki) Агрегация логов всех сервисов Поиск по логам через Grafana Корреляция логов с метриками 5. Distributed Tracing (Jaeger) Трейсинг HTTP запросов между сервисами Визуализация цепочек вызовов Поиск узких мест (bottlenecks) Анализ latency по сервисам 6. Алертинг Алерты в Telegram Эскалация критичных проблем On-call ротация Автоматическое создание инцидентов Технологии Prometheus Grafana Kubernetes Docker Helm Linux Результаты ✅ MTTD: обнаружение проблем с 30 минут до 1 минуты ✅ MTTR: время восстановления сократилось на 60% ✅ Алерты: автоматические уведомления в Telegram ✅ Visibility: полная прозрачность работы всех сервисов ✅ Capacity planning: данные для планирования ресурсов